Forklaring
Planlegging
nav-pilot foreslår, du godkjenner. Slik er planleggingen bygget opp, og hvorfor.
Planleggingen
Agenten @nav-pilot planlegger i fire faser, med et stopp mellom hver. Du bestemmer når den går videre. Agenten er tynn: den velger fase og henter en skill. Kunnskapen ligger i skillene, i beslutningstrær, sjekklister og diagnosetrær.
De fire fasene
Intervju
— Dypdykk-intervju- Personvern. Behandler dere PII? Hvilke kategorier?
- Auth. Hvem kaller tjenesten? Bruker, tjeneste eller ekstern partner?
- Avhengigheter. Hva skjer når en avhengighet er nede?
- Endringspåvirkning. Hvem konsumerer dine API-er/hendelser?
- Teststatus. Hva er testdekningen i koden som endres?
- Observerbarhet. Hvilke forretningsmetrikker viser at tjenesten fungerer?
Skillene
Agentpakka har fire skills for planlegging. Du kan også bruke dem uten agenten.
| Skill | Hva den gjør | Dekker |
|---|---|---|
$nav-deep-interview | Strukturert intervju som avdekker blindsoner (personvern, auth, avhengigheter) | Personvern og data, Plattform og auth, Observerbarhet, Team og prosess data-classification.md, blind-spots.md (25+ vanlige blindsoner fra ekte Nav-repoer) |
$nav-plan | Går fra beslutningstrær til Nais-manifest, CI/CD og prosjektstruktur | Auth-beslutningstre, Kommunikasjonstre, Database-tre, accessPolicy-tre decision-trees.md, nais-templates.md (5 arketyper) |
$nav-architecture-review | Gjennomgår fra tre perspektiver og skriver en ADR | Arkitektur, Sikkerhet, Plattform adr-template.md, nav-principles.md (Team First, essensiell kompleksitet, DORA) |
$nav-troubleshoot | Diagnostiske trær for vanlige Nav-plattformproblemer | Pod krasjer (CrashLoopBackOff), 401/403, Kafka consumer lag, DB-tilkobling feiler, Treg responstid, Deploy feiler diagnostic-trees.md |
Kompetansebevaring
Utviklere som lar modellen skrive alt, forstår sin egen kode dårligere. I Anthropics randomiserte studie (2026) fikk de som brukte KI-hjelp 50 % i snitt på en kunnskapstest, mot 67 % for dem som kodet for hånd. De som delegerte alt, fikk under 40 %. De som stilte spørsmål for å forstå koden, fikk 65 % eller mer. Navs egen langtidsstudie (Stray mfl., HICSS-59 2026) viser det samme mønsteret.
Samtidig viser studien fra MIT og Microsoft (2025, rundt 5 000 utviklere) at KI-hjelp gir mest på repetitive oppgaver. På oppgaver som krever at du forstår domenet, forsvinner gevinsten, og den kan bli negativ.
Grønn og rød sone
nav-pilot deler derfor planen i to. I fase 2 (Plan) merker den hver del som grønn eller rød sone. Risikoen vurderer du selv, se under. I fase 4 leverer den full kode for det grønne. For det røde får du testskjeletter og stubber med TODO, og skriver kjernelogikken selv.
Sonen svarer på om du skal lære dette. Risikoen svarer på hva som skjer hvis agenten tar feil: lav, middels eller høy. Oppgaver som berører nettverk, hemmeligheter, MCP-servere, produksjon eller persondata, har høy risiko, også når de er grønne. Konfigurasjon og infrastruktur er ikke automatisk lav risiko.
Jo høyere risiko og jo mer agenten jobber på egen hånd, jo strengere kontroller trengs. Lokalt kjører agenten i cplt med sandbox og git guard. I bakgrunnen eller i skyen jobber agenten på én branch per oppgave, CI må passere, og et menneske merger alltid.
- Boilerplate og repetitiv kode (Nais-manifest, CRUD)
- Teknologi du kan fra før
- Refaktorering med kjent mål
- Testdata og fixtures
- Feilsøking
- Nye konsepter og ukjent teknologi
- Kjernelogikk og forretningsregler
- Sikkerhetskritisk kode
- Arkitekturbeslutninger
Slik ser det ut
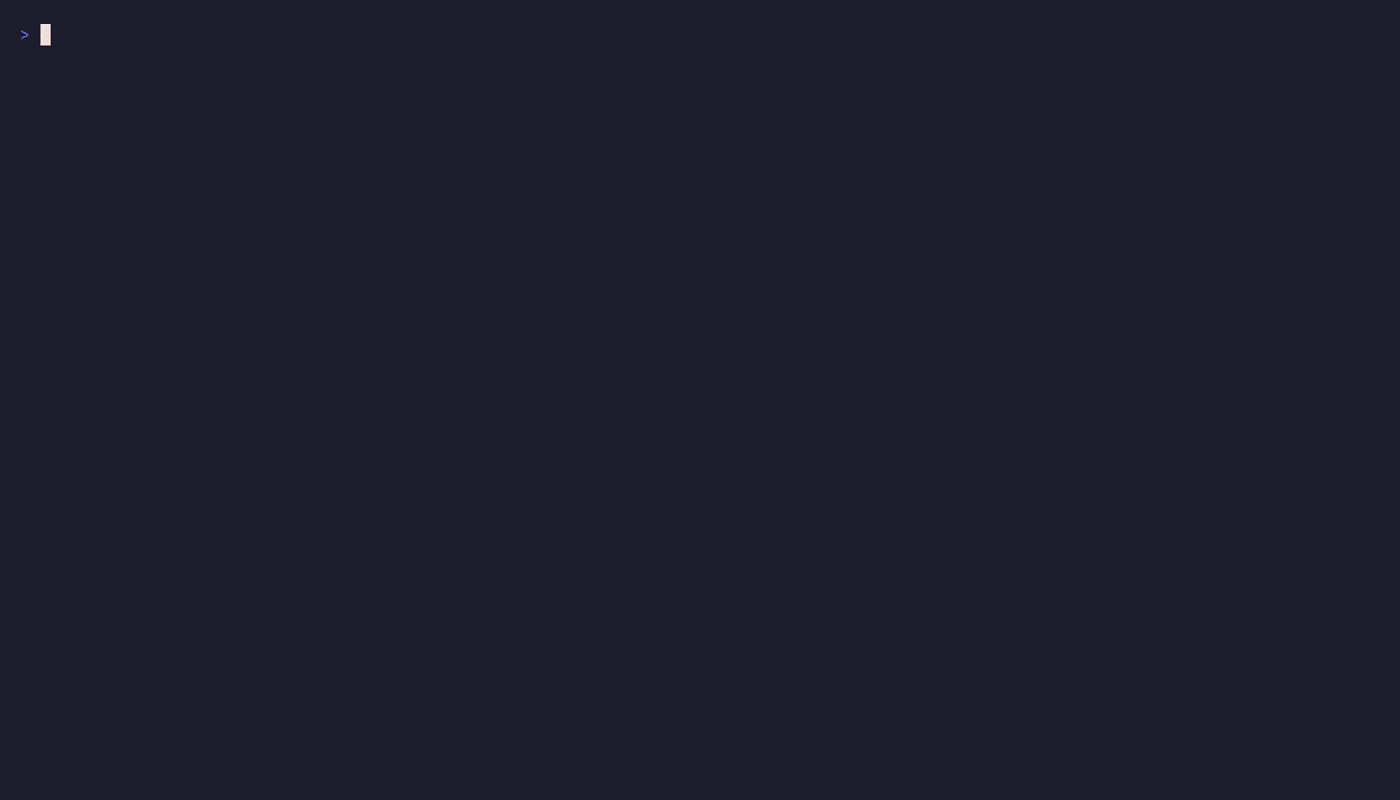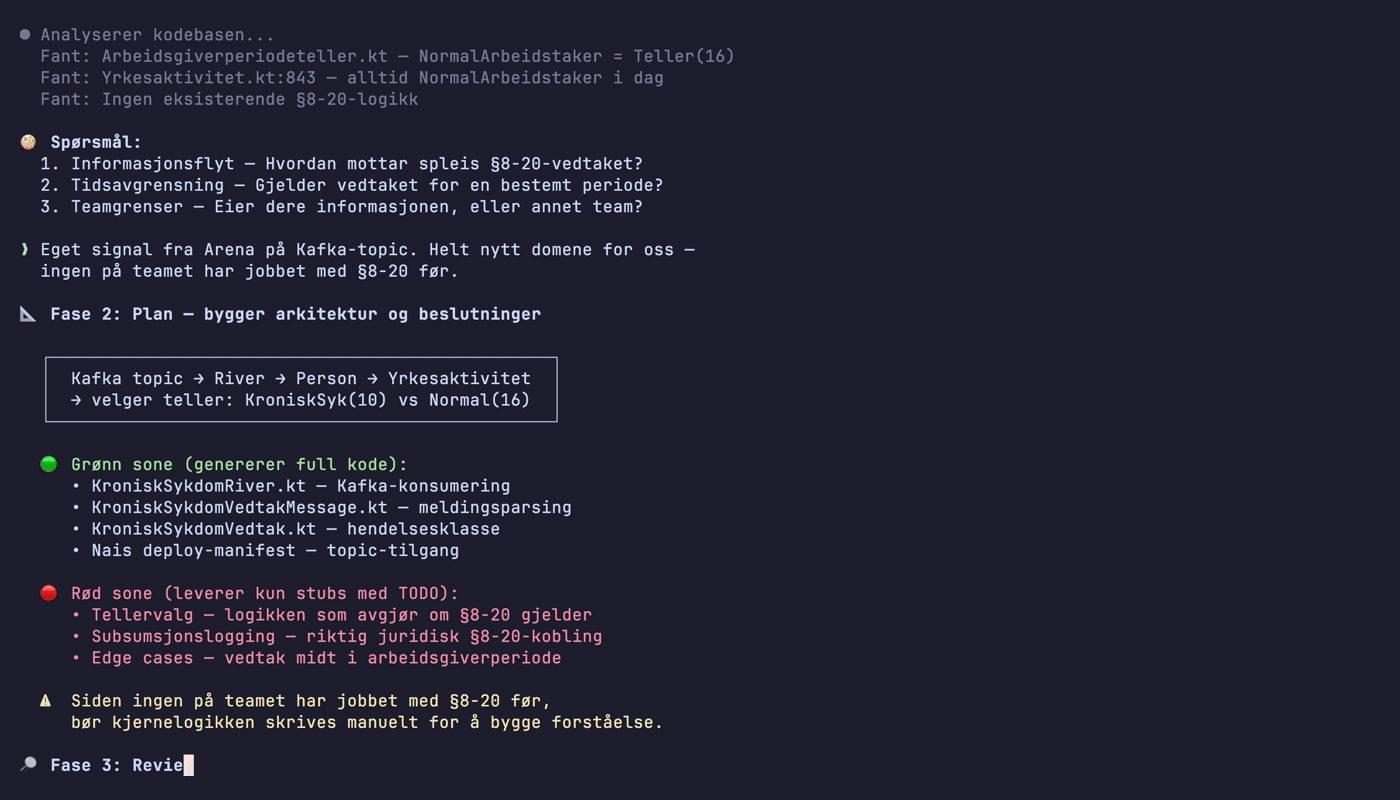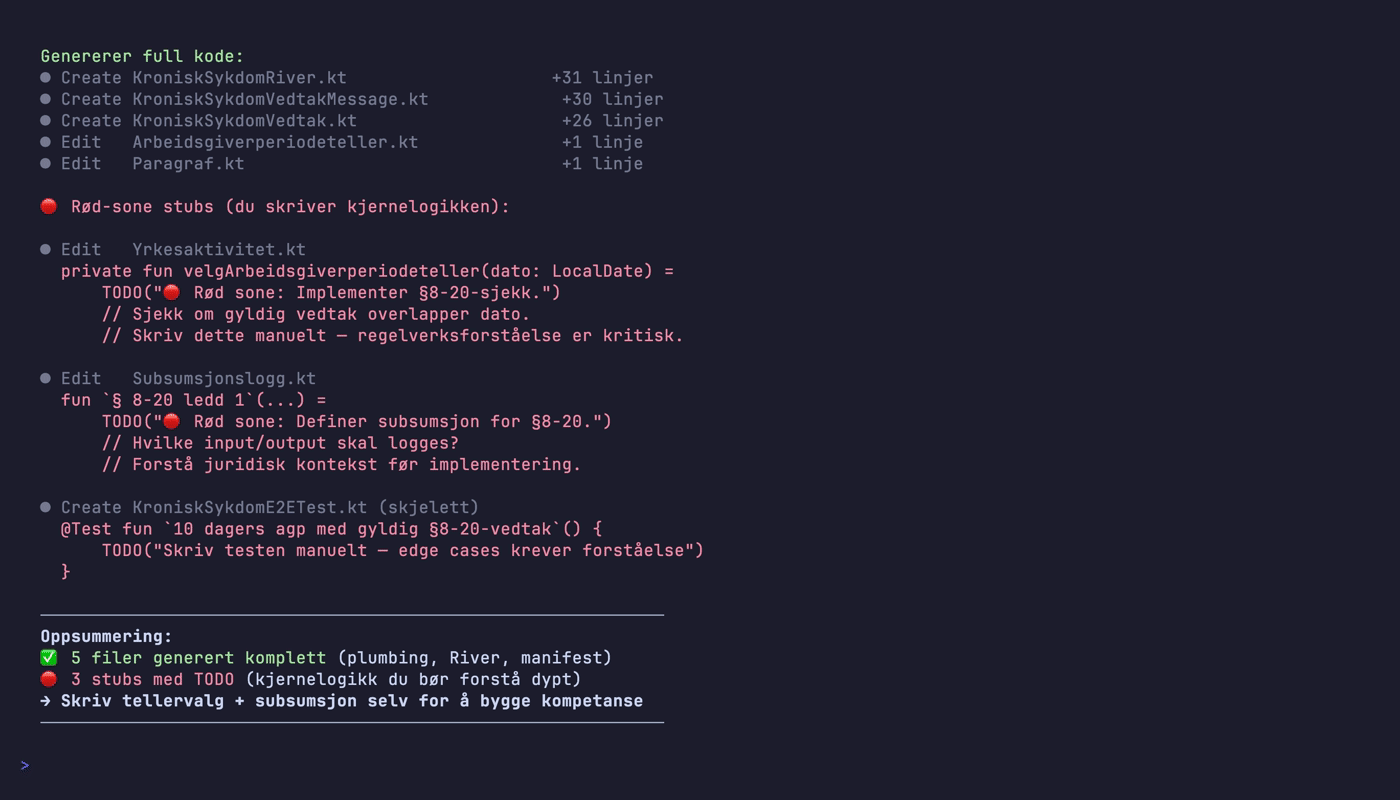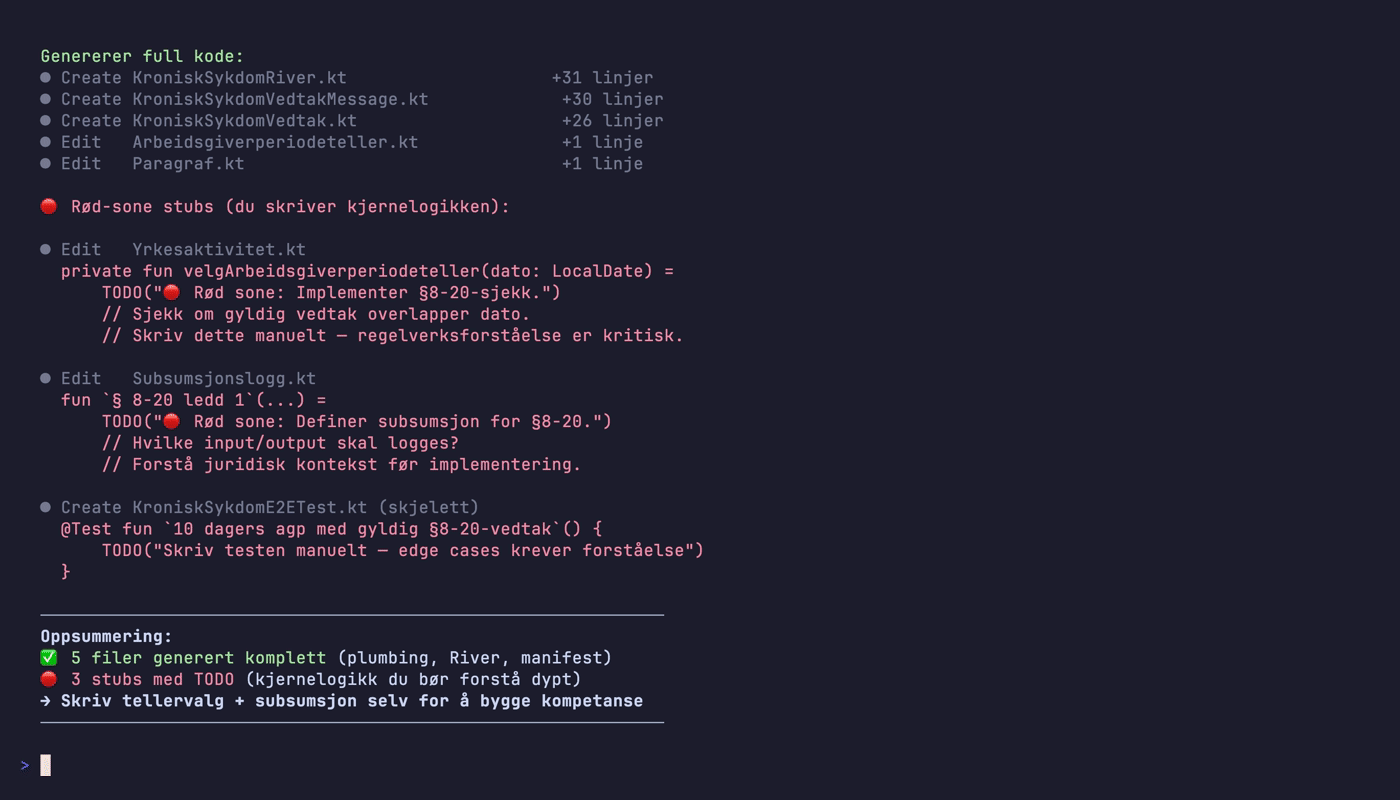
Her planlegger nav-pilot en ny beregningsregel for sykepenger (§ 8-20). Koden rundt regelen er grønn sone, selve regelverket er rødt.
Kilder: Anthropic, METR og studien fra Nav IT.